 Mason Hönicke
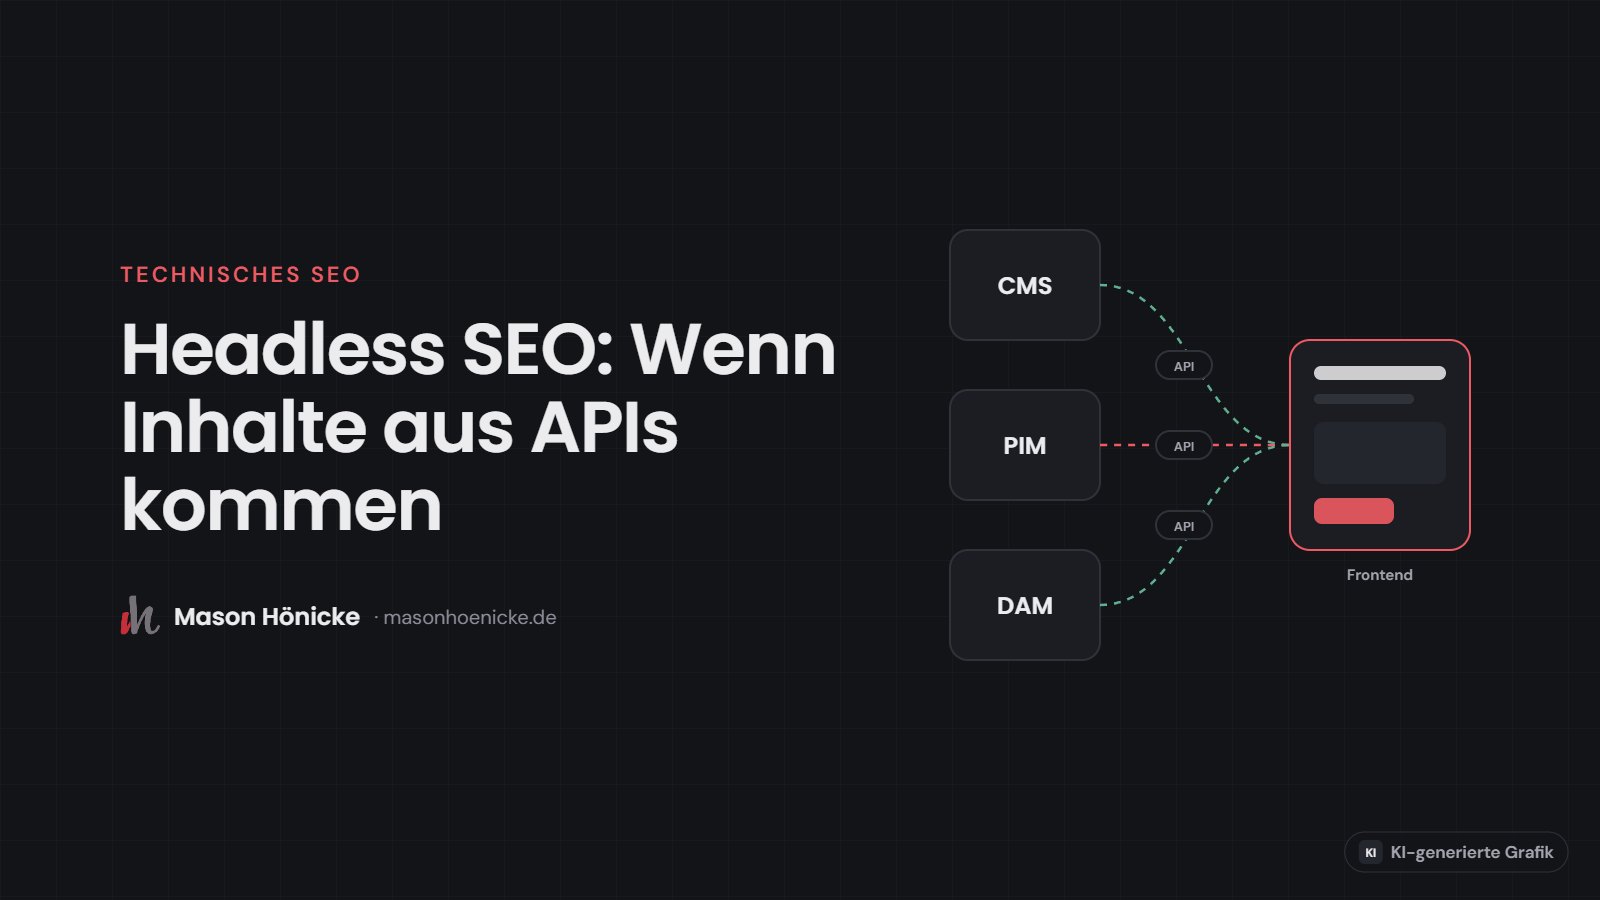
Früher war die Welt für SEOs übersichtlich: ein CMS, ein Template, eine Website. Title, Canonical und Inhalte lagen an einem Ort, und wer etwas ändern wollte, wusste, wo. Heute werden immer mehr Websites und Shops „headless“ gebaut. Inhalte kommen per API aus dem CMS, Produktdaten aus dem PIM, Bilder aus dem DAM, und das Frontend setzt alles erst beim Ausliefern zusammen.
Über genau diesen Wandel habe ich 2025 auf der SEO CAMPIXX und der SEOCruise gesprochen: „SEO in einer Welt von APIs“. Dieser Artikel fasst die wichtigsten Punkte zusammen, ergänzt um den aktuellen Stand der Google-Dokumentation und die Frage, was Headless für die Sichtbarkeit in KI-Suchen bedeutet.
Das Wichtigste in Kürze
- In Headless-Setups kommen SEO-relevante Daten aus mehreren Systemen. Das macht sie fehleranfälliger und die Verantwortung unklar.
- Antwortet eine API zu langsam oder gar nicht, sieht Google eine leere oder unvollständige Seite und kann genau die indexieren.
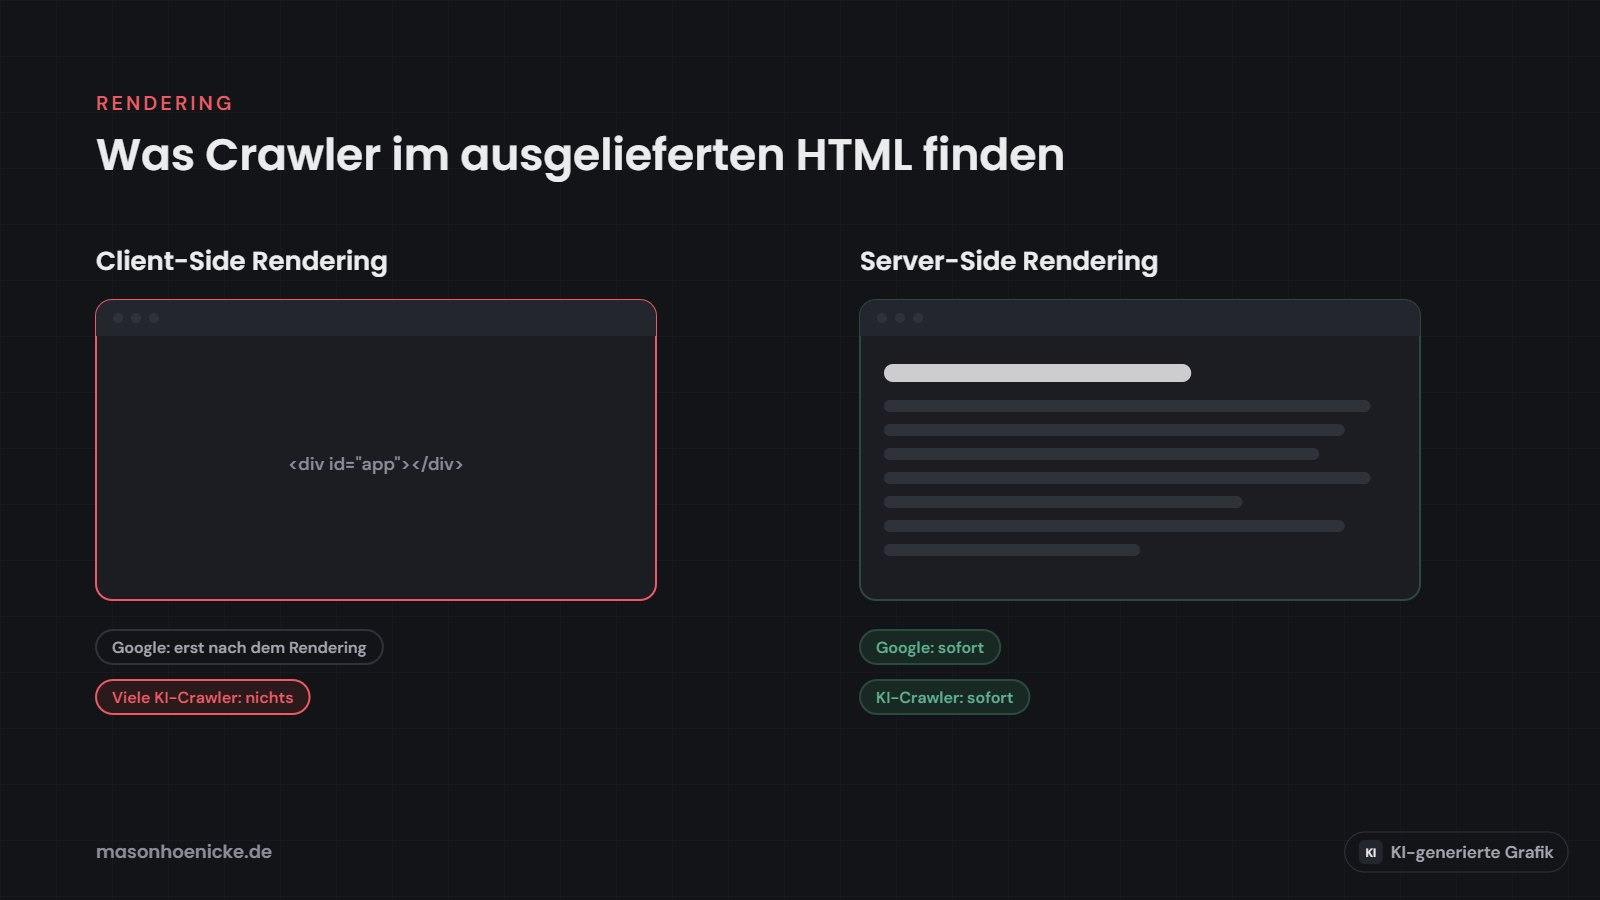
- Server-Side Rendering oder statische Generierung ist für SEO der sicherere Weg. Viele KI-Crawler führen kein JavaScript aus.
- SEO muss in Architektur, QA und Monitoring stattfinden, nicht erst nach dem Go-live.
- Vor jedem Headless-Projekt gehört auf den Tisch: Woher kommt jedes SEO-Feld, und wer ist dafür verantwortlich?
1. Was Headless eigentlich bedeutet
Headless heißt: Das Frontend ist vom Backend getrennt. Das CMS verwaltet nur noch Inhalte, die Darstellung übernimmt eine eigene Anwendung. Die Inhalte werden über Schnittstellen (REST oder GraphQL) ausgeliefert und können so gleichzeitig auf Website, App oder anderen Kanälen erscheinen.
Für Entwicklung und Marketing hat das viele Vorteile: mehr Flexibilität, schnellere Frontends, Inhalte für mehrere Kanäle. Für SEO bedeutet es vor allem eines: Es gibt kein System mehr, das alles zusammenhält. Klassische CMS wie WordPress oder TYPO3 bringen Templates mit, in denen Title, Meta-Daten und Canonical fest verdrahtet sind. Ein Headless-CMS liefert nur Daten. Was daraus im HTML wird, entscheidet das Frontend, und zwar bei jedem Deployment neu.
2. Die API antwortet nicht, Google schaut trotzdem
Das größte Risiko in Headless-Setups ist selten der Inhalt, sondern die Verfügbarkeit. Wenn eine API verzögert oder gar nicht antwortet, liefert das Frontend im Zweifel eine leere oder unvollständige Seite aus: ohne Title, ohne Beschreibung, ohne Produktinformationen. Kommt der Googlebot genau in diesem Moment vorbei, sieht er diese Version. Und er kann sie indexieren, selbst wenn eine Minute später wieder alles korrekt ausgeliefert wird.
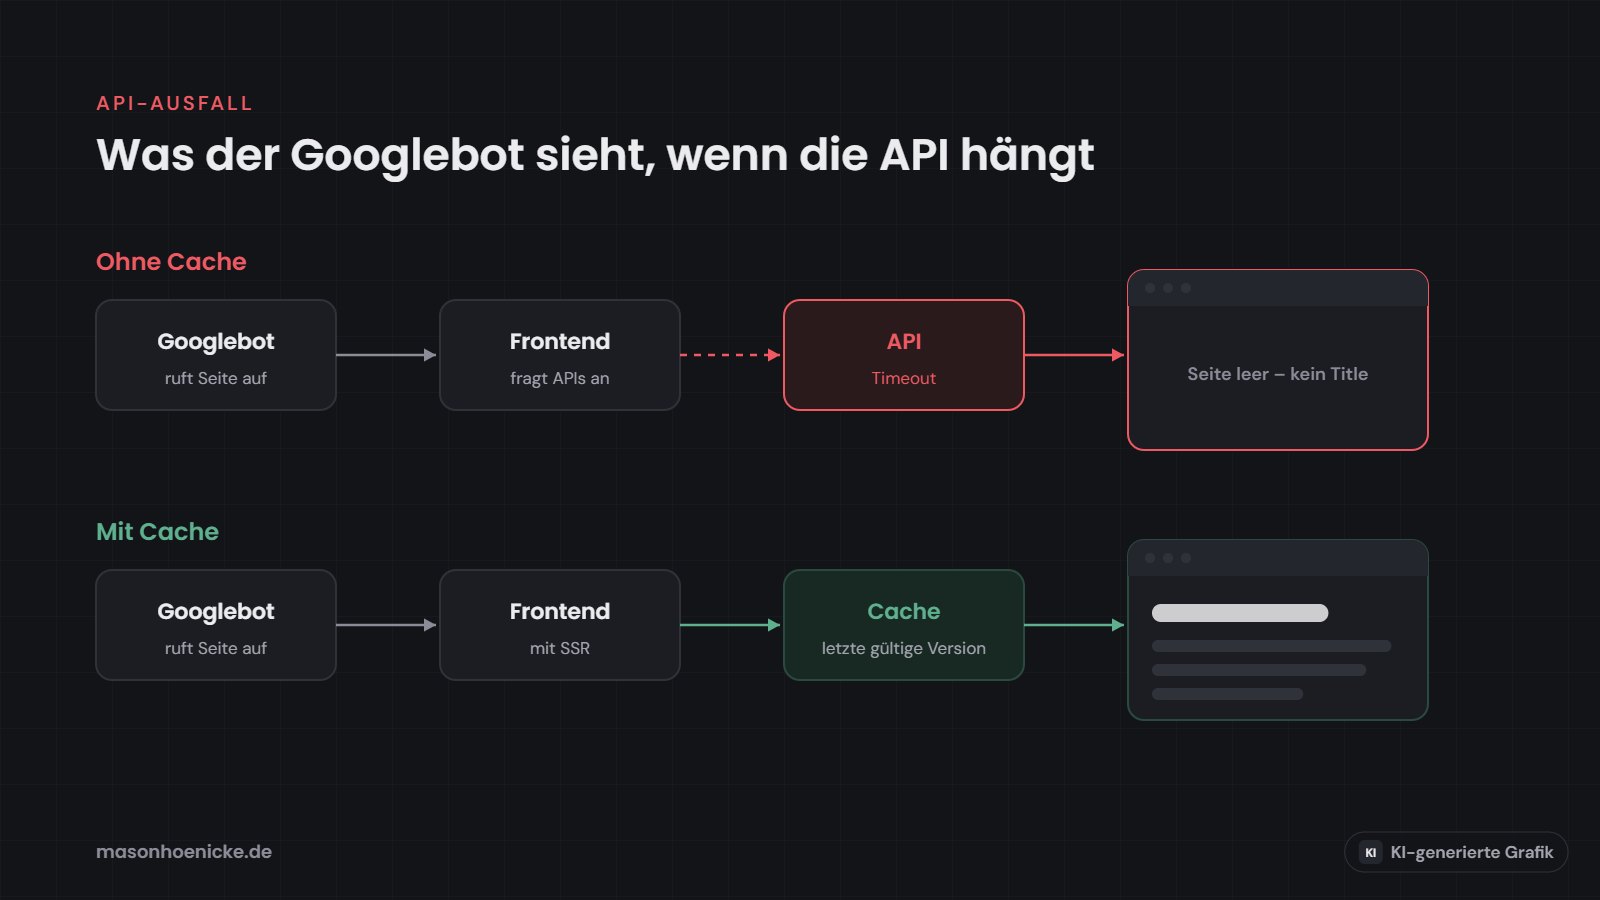
Wenn die API 2 Sekunden Timeout hat, bringt der schönste Title nichts.
Was dagegen hilft:
- Caching und Fallbacks: Server-Side Rendering mit einem Cache auf Server- oder Edge-Ebene hält Inhalte auch dann verfügbar, wenn eine Quelle kurz ausfällt, zum Beispiel per „Stale-While-Revalidate“: Es wird die zuletzt gültige Version ausgeliefert, während im Hintergrund aktualisiert wird.
- Korrekte Statuscodes: Fehlt ein Inhalt wirklich, sollte die Seite einen Fehlercode liefern und keine leere Seite mit Status 200.
- Monitoring als Frühwarnsystem: API-Ausfälle und fehlende SEO-Elemente müssen auffallen, bevor Google sie crawlt, nicht erst Wochen später in der Search Console.
3. Rendering entscheidet, was Suchmaschinen sehen
Wie eine Headless-Seite gerendert wird, ist die wichtigste technische Entscheidung für SEO. Die drei gängigen Varianten im Vergleich:
| Rendering | Was passiert? | Vorteile | Nachteile |
|---|---|---|---|
| CSR (Client-Side Rendering) | Der Server liefert ein fast leeres HTML, Inhalte werden per JavaScript im Browser nachgeladen. | Einfache Entwicklung, dynamische Oberfläche | Crawler sehen zunächst wenig, SEO-Daten kommen spät |
| SSR (Server-Side Rendering) | HTML wird auf dem Server erzeugt und vollständig ausgeliefert. | SEO-freundlich, Inhalte sofort sichtbar | Aufwendiger, anfällig bei API-Ausfällen ohne Cache |
| SSG (Static Site Generation) | Seiten werden beim Build als statische HTML-Dateien erzeugt. | Schnell und stabil | Ungeeignet bei häufigen Änderungen, lange Build-Zeiten bei großen Websites |
Client-Side Rendering ist nicht automatisch schlecht. Google rendert JavaScript, allerdings in einem zweiten Schritt: Laut Googles Leitfaden zu JavaScript-SEO landen Seiten nach dem Crawlen in einer Warteschlange fürs Rendering, die von Sekunden bis deutlich länger dauern kann. Google selbst empfiehlt Server-Side Rendering oder Pre-Rendering, weil es für Nutzer und Crawler schneller ist und „nicht alle Bots JavaScript ausführen können“.
Das gilt besonders für KI-Systeme. Eine Auswertung von Vercel aus dem Dezember 2024 zeigte, dass die großen KI-Crawler wie GPTBot, ClaudeBot und PerplexityBot JavaScript zwar herunterladen, aber nicht ausführen. Das kann sich ändern, aber ich würde nicht darauf wetten. Wer in ChatGPT, Perplexity und Co. zitiert werden will, sollte die wichtigsten Inhalte im ausgelieferten HTML haben.
Meine Faustregel: SSR ist der Sweet Spot für Shops und dynamische Inhalte. SSG eignet sich für Marketing-Seiten, Dokumentationen und überschaubare Produktseiten, solange die Build-Zeiten im Rahmen bleiben. Für alles, was ranken oder zitiert werden soll, ist reines CSR das Risiko, das man sich sparen kann.
4. Zwei Leser, zwei Logiken: Googlebot und Sprachmodelle
In einer Headless-Welt hast du es mit zwei sehr unterschiedlichen Lesern zu tun. Beide scheitern an anderen Problemen:
| Googlebot | Sprachmodelle (LLMs) | |
|---|---|---|
| Input | HTML, DOM, strukturierte Daten | Text und semantischer Kontext |
| Logik | Technisch und regelbasiert | Sprachlich und wahrscheinlichkeitsbasiert |
| Erwartung | Sauberer Code, vollständige Meta- und Strukturdaten | Konsistenter, verständlicher Inhalt ohne Widersprüche |
| Typisches Problem | Kein oder spätes Rendering, die Seite ist leer oder unvollständig | Fragmentierter Content, der Zusammenhang geht verloren |
Der zweite Punkt wird oft übersehen: Wenn Produktname aus dem PIM, Beschreibung aus dem CMS und Ratgebertext aus einem dritten System kommen, passen die Teile nicht immer zusammen. Widersprüchliche Angaben, doppelte Textbausteine oder fehlender Kontext machen es Sprachmodellen schwer, eine Seite als verlässliche Quelle zu verstehen.
5. Wer ist eigentlich für den Canonical verantwortlich?
In einem klassischen CMS war die Frage einfach. In Headless-Setups kommen SEO-relevante Informationen typischerweise aus vier bis fünf Quellen: Der Title steht vielleicht im CMS, die Canonical-Logik sitzt in der Middleware, hreflang hängt am Frontend-Code, strukturierte Daten werden aus dem PIM generiert. Die Folgen:
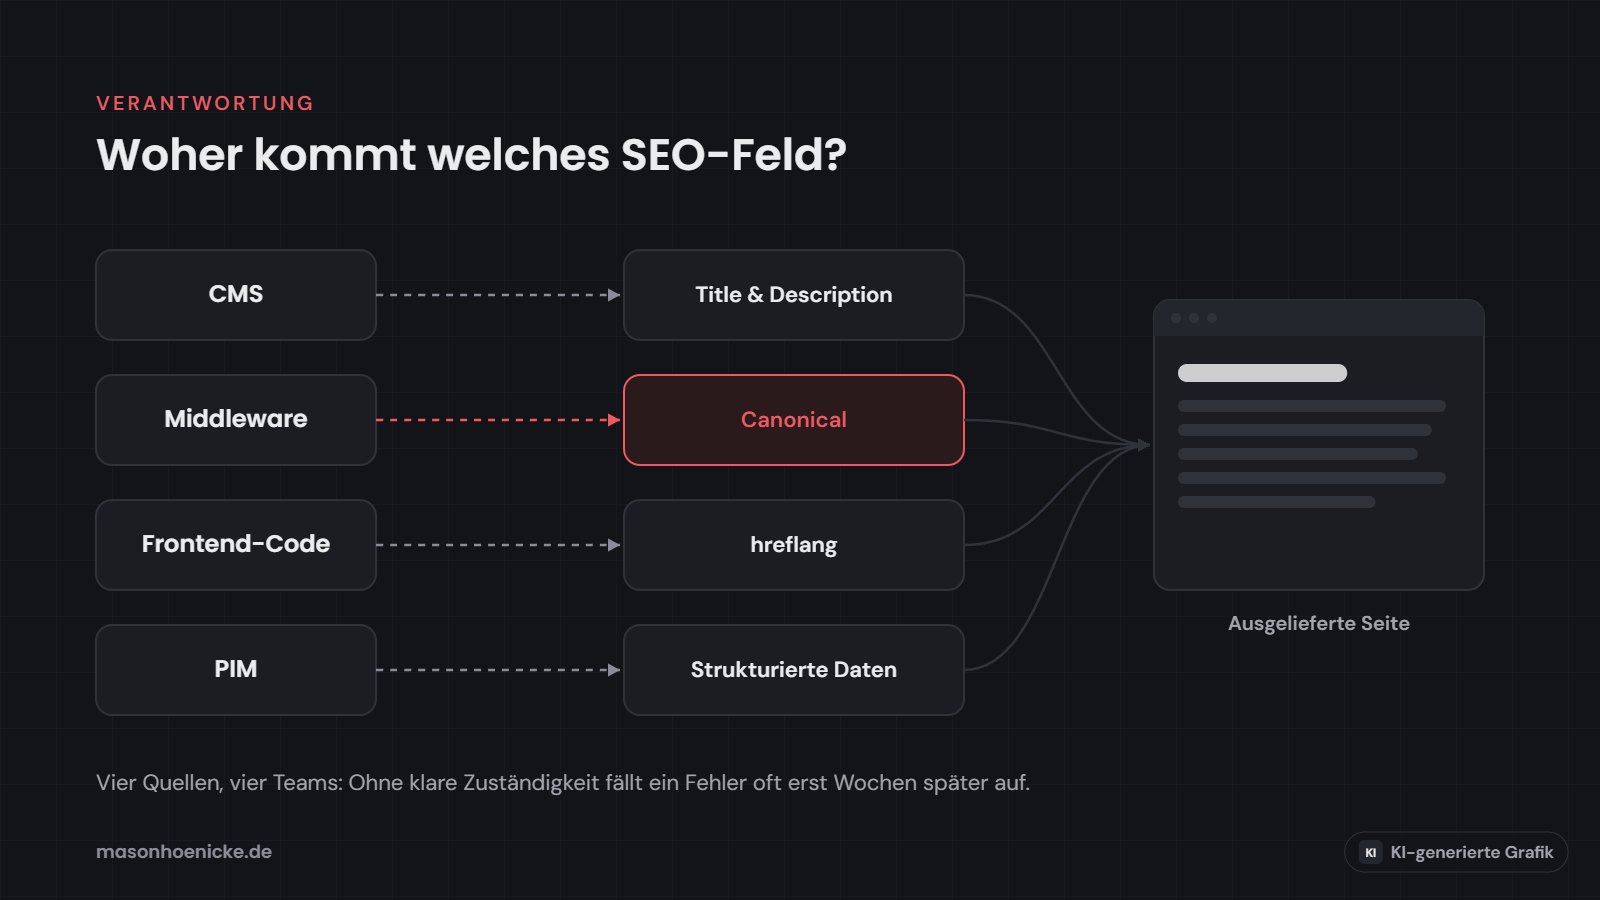
- Kleine Änderungen in einem System können SEO-Elemente in einem anderen unbemerkt kaputt machen.
- Die Verantwortung ist auf mehrere Teams verteilt, und keines fühlt sich zuständig, wenn etwas schiefgeht.
- Es gibt keine einzige Quelle der Wahrheit, gegen die man prüfen kann.
Wer nicht weiß, wo sein Canonical herkommt, sollte keine neue Landingpage bauen.
Gerade beim Canonical lohnt sich Sorgfalt. Google wertet ihn als starkes Signal, aber nicht als Befehl. Laut Google sollte ein per JavaScript gesetzter Canonical mit dem im ausgelieferten HTML übereinstimmen, und es darf nur einen Canonical pro Seite geben. In Setups, in denen Server und Client je eigene Tags erzeugen, ist genau das eine häufige Fehlerquelle.
6. SEO ist ein Feature, kein Checkpoint
Die meisten SEO-Fehler in Headless-Umgebungen entstehen nicht im Text, sondern im System: fehlende Canonicals, kaputte hreflang-Tags, fehlerhafte API-Antworten. Deshalb reicht es nicht, wenn SEO am Ende eines Projekts einmal drüberschaut. SEO muss dort stattfinden, wo Architekturentscheidungen getroffen werden.
Konkret heißt das:
- Canonical, hreflang und strukturierte Daten sind keine Redaktionsaufgaben, sondern Schnittstellenthemen, die Entwicklung und QA von Anfang an mitdenken.
- Für jede SEO-Komponente gibt es eine klar benannte Zuständigkeit, zum Beispiel in Entwicklung, QA oder Produkt.
- SEO gehört in die QA-Pipeline, genau wie Performance, Tracking oder Barrierefreiheit.
- SEO-Anforderungen stehen als Akzeptanzkriterien in den Tickets, nicht in einem separaten Dokument, das niemand liest.
Das macht SEOs nicht zu Entwickler:innen. Aber es macht sie zu Produktpartner:innen, die ernst genommen werden, weil sie dort mitreden, wo die Entscheidungen fallen.
7. Crawling reicht nicht: Monitoring für Infrastruktur und APIs
Ein wöchentlicher Crawl und ein Blick in die Search Console reichen in Headless-Setups nicht aus. Fehler entstehen bei Deployments oder API-Ausfällen und können innerhalb von Stunden große Teile der Website betreffen. SEO-Monitoring muss deshalb auch die Infrastruktur im Blick haben:
| Werkzeug | Einsatzbereich | Typische Probleme, die auffallen |
|---|---|---|
| Testomato | Laufende Checks auf Live-Seiten: Title, Canonical, hreflang, Textbausteine | Title nach Deployment verschwunden, Canonical zeigt auf falsche URL, hreflang fehlt plötzlich |
| Datadog | API- und Systemmonitoring: Antwortzeiten, Verfügbarkeit, Logs | Lange Serverantwortzeiten, fehlerhafte JSON-Ausgaben, API-Antworten mit 500 oder Timeout |
| Screaming Frog (JS-Rendering) | Crawling mit JavaScript-Rendering und SEO-Fokus | Seite rendert unvollständig, strukturierte Daten fehlen, Meta-Tags nur clientseitig vorhanden |
| Google Lighthouse | Performance- und Qualitätsanalyse inklusive Core Web Vitals | Layout-Verschiebungen, langsamer erster Seitenaufbau |
Der wichtigste Schritt ist dabei nicht das Werkzeug, sondern die Alarmierung: Wenn der Title auf hunderten Produktseiten fehlt, muss das jemand innerhalb von Stunden erfahren, nicht im nächsten Monatsreport.
8. Checkliste vor dem Headless-Projekt
Headless ist keine reine Frontend-Entscheidung. Wer umstellt, sollte diese Punkte vor dem Projektstart klären:
- API-Content-Map erstellen: Welche Inhalte kommen aus welchem System (CMS, PIM, DAM, Middleware)?
- Quellen aller SEO-Felder klären: Wer verantwortet Title, Description, Canonical, hreflang und strukturierte Daten?
- Jede Quelle prüfen, nicht nur das Rendering: Ein Canonical aus dem CMS nützt nichts, wenn er ins Leere zeigt. Und ein optimiertes Frontend hilft wenig, wenn das PIM fehlerhafte Daten liefert.
- SEO-relevante Datenflüsse früh definieren: sonst wird SEO zur Notlösung im Deployment-Prozess.
- SSR- oder Hybrid-Konzept von Anfang an planen: Rendering ist Teil der Architektur, kein „SEO-Fix“ nach dem Go-live.
- Test- und Abnahmepunkte für SEO festlegen: so selbstverständlich wie für Tracking, UX oder Performance.
- Monitoring mit Alarmen aufsetzen: für SEO-Elemente und die APIs, die sie liefern.
Häufige Fragen
Ist Headless schlecht für SEO?
Nein. Headless-Setups können sehr gut ranken und sind oft schneller als klassische Systeme. Das Risiko liegt nicht in der Technologie, sondern darin, dass SEO-Verantwortung und Rendering nicht von Anfang an mitgeplant werden.
Kann Google JavaScript-Seiten indexieren?
Ja, Google rendert JavaScript, allerdings zeitversetzt. Inhalte, die nur clientseitig erscheinen, werden daher später und weniger zuverlässig erfasst. Viele andere Crawler, darunter KI-Crawler, führen JavaScript gar nicht aus.
Was ist besser für SEO: SSR oder SSG?
Beides funktioniert gut. SSR eignet sich für große, sich häufig ändernde Websites wie Shops. SSG ist ideal für Seiten, die sich selten ändern. Viele Projekte kombinieren beides.
Wer sollte in einem Headless-Projekt für SEO verantwortlich sein?
Für jedes SEO-Element sollte es eine benannte Zuständigkeit geben, meist in Entwicklung oder Produkt. Die SEO-Verantwortlichen definieren die Anforderungen, prüfen die Umsetzung und überwachen den Betrieb.
Mein Fazit
Headless verändert nicht, was gutes SEO ausmacht, sondern wo es stattfindet. Statt im Redaktionssystem entscheidet sich Sichtbarkeit heute in Schnittstellen, Rendering-Konzepten und Deployment-Prozessen. Wer früh klärt, woher jedes SEO-Feld kommt, wer dafür verantwortlich ist und wie Fehler auffallen, macht aus der neuen Architektur einen Vorteil, für Google und für KI-Suchen.
Du planst einen Relaunch oder eine Umstellung auf Headless? Lass uns sprechen, am besten bevor die Entwicklung startet.